澳门人威尼斯4399观点 | VLA or 世界模型——智能驾驶技术路线竞争将走向何方

首页

澳门人威尼斯

2026-05-11

点击次数:
-
字号:大中小

2026年,智能驾驶技术已成为智能网联汽车竞争的焦点,技术分化愈发明显,行业洗牌加速上演。当前,全国20余个城市开放自动驾驶商业化运营试点,L3级车型准入与上路规则逐步明晰。智能驾驶技术的"强弱"已成为智能网联汽车迈入具身智能体的关键门槛之一。本文系统梳理当前主流智能驾驶的发展概况、技术特点与优劣差异,研判VLA和世界模型的技术发展方向,以及展望两类技术融合后的应用场景。
一、主流智能驾驶技术竞争态势概述
智能驾驶技术的构想最早可追溯至20世纪30年代,由通用汽车率先提出无线电控制高速公路自动驾驶技术构想。21世纪初,随着多届DARPA无人驾驶挑战赛的举办,确立了智能驾驶"感知+定位+规划+决策+控制"的模块化架构体系。2015年后,随着新能源汽车的大规模量产,以特斯拉为代表的高阶辅助驾驶技术逐步实现商业化落地。2023年,伴随着人工智能大模型的突破式发展,智能驾驶与人工智能实现深度融合,量产车正式进入高阶智驾阶段。因此,本文认为2023年也可称为高阶智驾元年。
历经三年技术迭代,至2026年,智能驾驶技术从早期探索阶段进入稳定发展期。当前,市面上主流的技术路线有三种,以华为、Momenta、蔚来为代表的世界模型路线,以理想、小鹏、元戎启行为代表的VLA路线,以及特斯拉的纯视觉端到端技术路线。本文重点围绕VLA与世界模型展开分析。
二、VLA与世界模型技术特征及优劣分析
VLA模型全称为Vision-Language-Action Model,即视觉—语言—动作模型。核心能力为环境视觉感知、自然语言理解与动作执行,是具备高度拟人化特征的智能驾驶技术。
世界模型通过将物理世界构建为动态仿真环境,基于虚拟环境学习物理规律、推演未来状态,进而实现最优决策,是具备高精度环境认知与预测能力的智能驾驶技术。
(一)主要特点
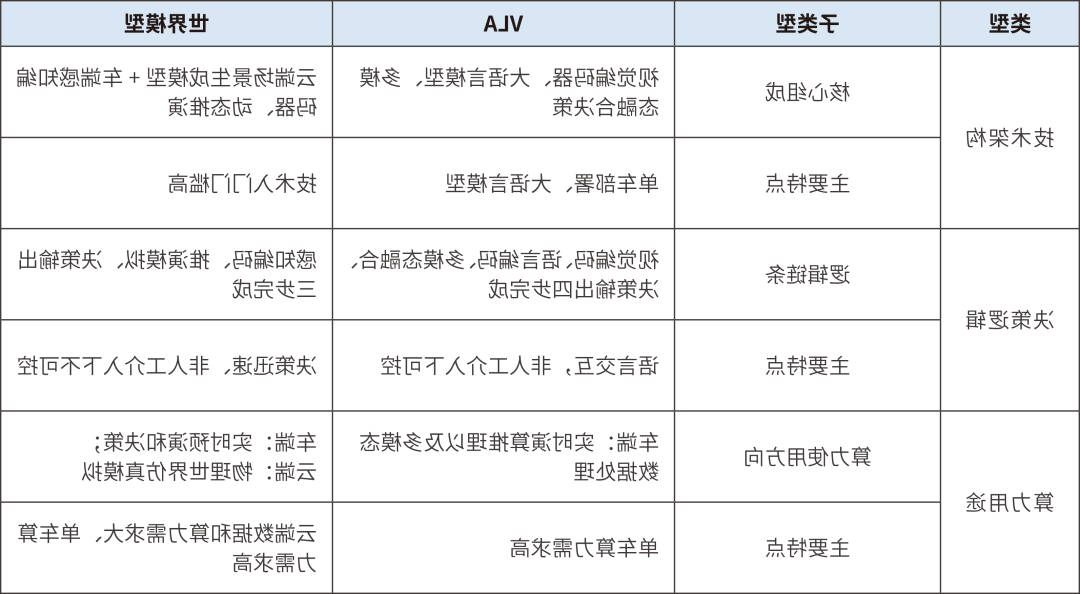
技术架构——VLA拥有视觉编码器、大语言模型、多模态融合决策三大模块,具有单车部署优势,可快速实现量产化。世界模型采用"云端+车端"双层架构,云端部署场景生成引擎,如华为的World Engine,车端部署感知编码器、动态推演两大模块。该架构高度依赖云端算力支撑,技术门槛与资金投入呈指数级提升。
决策逻辑——VLA决策流程分为视觉编码、语言编码、多模态融合、决策输出四个环节,支持通过自然语言控制与修正驾驶行为,人机可控性较强。世界模型决策流程分为感知编码、推演模拟、决策输出三个环节,响应速度更快,非人工介入状态下可控性较弱。
算力用途——VLA算力集中于车端,主要用于实时演算推理以及多模态数据处理(自然语言、视觉编码)等工况。世界模型的算力分为云端和车端,云端用于生成和模拟各类复杂物理世界状态,车端用于实时预演和决策。云端算力需求规模极大,华为世界引擎云端算力达45EFLOPS。
表1 VLA、世界模型主要特点横向对比
表格信息来源:澳门人威尼斯4399根据公开信息整理
(二)优劣势分析
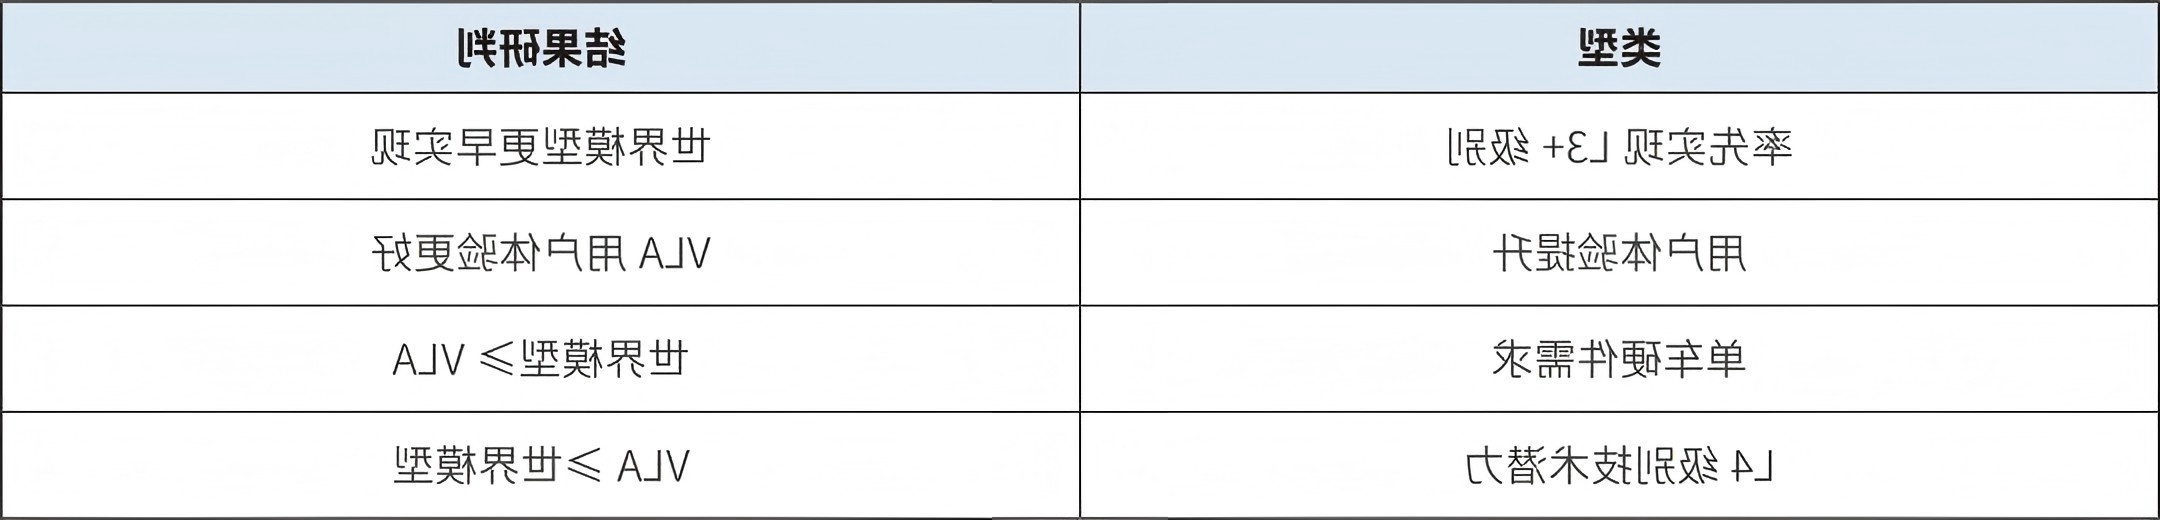
基于上述特点可见,两大技术路线有以下四大优劣势之分。
一是行为模式差异,一个像"人类司机"、一个像"规则执行者"。VLA技术得益于自然语言交互优势,在人机互信、驾驶风格等方面做到充分理解、认识人类行为,在面对复杂场景时可以做到人机共驾。世界模型受益于大规模的云端模拟仿真以及车端较为简单的执行逻辑,在规则执行、快速响应等方面具有明显优势,理论上安全性更高、决策更加果断,但面对仿真与现实之间的极少数"鸿沟"场景,无法实现人机共驾。
二是技术迭代模式不同,一个需要"自己一直开"、一个需要"大家一起开"。VLA模型可记忆驾驶者的各类驾驶偏好,通过个性化培养逐步形成类似驾驶者本人的智驾风格,类似OpenClaw,理论上可以做到千人千面。世界模型则需要大规模的模拟场景、数据作为云端训练的基础,在少量实车的情况下也可通过模拟实现技术快速迭代。进入技术成熟期,则需要"大家一起开"来积累大规模实车数据,从而实现长尾场景不断延伸,最终突破数据局限。
三是优势应用场景不同,一个适合城市场景,一个适合复杂路况。VLA可以通过人机共驾,有效应对城市各类复杂场景,并记住驾驶者偏好,提升驾驶舒适度,但在极端天气下视觉传感精度下降,会导致智驾效率降低。世界模型由于云端模拟仿真带来的场景预演,在极端天气、罕见场景等方面有较大优势。具备应对复杂场景的能力也是率先实现L3以上智能驾驶的重要条件。
四是技术难度相当,对单车算力要求都很高。VLA除去环境感知和行为决策外,还加入了自然语言大模型,在自然语言和机器语言的多模态转换以及对口语、方言等非常规自然语言理解方面,拥有较高技术壁垒。世界模型则需要通过大量数据训练和算力堆砌,去突破仿真与现实之间的"鸿沟"。在算力需求方面,通过2025年9月理想汽车向所有AD
MAX用户推送的案例可以看出,VLA可以快速部署于单个车辆,在压减参数的基础上,拥有508TOPS算力的早期车型也可稳定运行。世界模型由于云端算力无法部署到单车,需要更多单车算力进行实时预演,随着世界模型的迭代,单车算力要求也会越来越高。
综上所述,本文认为世界模型、VLA均是我国实现L3级别驾驶的主力技术路线。VLA因"人机交互+语言控制"更易被用户感知和理解,而世界模型则需通过"低接管率+快速响应"直接体现智驾安全性。
表2 长期看VLA、世界模型优劣势(仅代表本文预测观点)
表格信息来源:澳门人威尼斯4399根据公开信息整理
三、VLA与世界模型技术融合为必然趋势
2025年8月,理想首发VLA智驾功能,在发布会中提出用小规模的世界模型生成模型场景,优化极端环境下的决策精度。2026年3月,小鹏宣布推送第二代VLA物理世界大模型,实现VLA+世界模型技术深度融合。从行业发展趋势来看,未来的智驾技术的演变方向就是VLA+世界模型融合,既融合了VLA人机互信、个性定制,又充分吸收了世界模型安全预演与长尾覆盖。VLA+世界模型的深度融合会引发以下四点技术突破,这些突破不仅将影响智能驾驶领域,也将成为具身智能体发展的重要方向。
推动AI对物理世界认知从"内化"到"感悟"。世界模型通过模拟实现了对物理世界的自主内化,让模型开始认识和遵守物理常识。VLA通过人机交互,协助模型去理解和感悟物理世界。两者融合有望彻底解决AI的"物理幻觉"问题,摆脱对显式编程和模拟仿真的依赖,为后续的驾驶决策、路径规划和动作执行奠定坚实基础,让智能驾驶的决策更贴合真实道路和驾驶的运行逻辑,提升复杂路况下的行驶安全性。
提升全感官具身交互能力与思维链(CoT)能力。VLA模型将推动智能驾驶系统从"单一感知"走向"类人感知",大幅提升人机交互自然度和驾驶控制精准度。融合VLA、世界模型的智能驾驶系统将全面融合语言(人类语言指令、人类感官反馈)、触觉(方向盘反馈、刹车力度感知)、力觉(轮胎抓地力感知)、听觉(车辆异响、路面噪声、鸣笛声)、热成像(夜间行人、障碍物识别)等多感官数据,让智能驾驶系统能够像人类一样"感知"行驶环境。全感官的交互数据,也将为世界模型训练提供更多模态可用数据,为提升长距离跨场景复杂任务思维链提供有效支撑,助力智驾系统生成结构化"思考过程"。
多模态闭环与人类指导实现深度融合。世界模型承担着智能驾驶虚拟场景生成的核心职责,但始终存在智能驾驶领域Sim-to-Real(仿真到现实)的鸿沟。VLA和世界模型融合后,世界模型基于VLA回传的人机共驾数据,持续优化虚拟场景构建与状态预测能力,形成"真实执行—数据回传—虚拟学习—策略优化—真实落地"的完整闭环。这种虚实融合的学习模式,规避了真实场景中试错成本高、学习效率低的局限,又实现了人类在AI训练中的纠错、指导能力。
支撑实现通用具身智能体。VLA与世界模型融合发展的最终目标,就是让汽车变成"可以看得清""可以想明白""知道干什么""也能听懂话"的通用具身智能体,这是推动自动驾驶迈向L5级别、实现全场景通用的重要技术基石。在此背景下,"我去上班,它去跑滴滴""没电了自己去充电""我和车商量着办"等科幻中的场景都将一一实现,汽车也将成为真正的硅基助理,而非代步工具。
综上所述,本文认为智能网联汽车将成为最早实现通用具身智能体的硬件终端。同时,VLA+世界模型技术将成为具身智能的核心技术范式。理由有三,一是智能网联汽车市场规模大,资金、人才密集,对发展VLA+世界模型技术具有先天优势。二是智能网联汽车经过超10年智能驾驶技术探索,已经奠定了实现智能终端设备数实融合的良好基础,即人工智能+硬件终端融合协同。三是从小鹏、理想等车企的发展战略来看,人形机器人已与VLA+世界模型技术呈现强关联态势。
四、VLA+世界模型技术应用场景展望
VLA+世界模型凭借实时感知、长程规划、虚拟推演等核心优势,正逐步渗透到千行百业,除了L4及以上智能驾驶领域外,VLA+世界模型技术在人形机器人、工业制造、医疗健康以及教育、科研、娱乐等强交互领域都将拥有长足应用。本文认为VLA+世界模型技术正在开启具身智能新纪元,推动人工智能在人类的指导下,从"理解世界"向"改造世界"跨越。
作者介绍
刘杨睿
咨询师
长期专注科技创新宏观研究,重点聚焦国有企业科技创新发展、科技服务业等领域,深度参与国家高新区、中关村领先科技园区、科技创新国际化等相关政策研究工作。
编辑:张 华
审核:孙 磊